
作者:王晓龙 阿里云技术专家;商静坤 阿里云高级开发工程师
在越来越多的数据分析场景中,数据库查询已经不再是处理链路的终点。查询得到的文本、图片等数据,还需要经过模型完成摘要、分类、信息抽取、语义判断或向量化,再进入后续分析。
一种常见的处理方式是:先通过 SQL 查询目标数据,再由应用程序调用模型。例如,从工单表中筛选尚未关闭的记录,交给模型生成摘要或判断类别,最后将结果写回数据库。当模型只处理少量数据时,这套方式足够简单;但随着模型调用逐渐成为常规的数据处理环节,问题也开始显现。
应用层不仅需要在数据库与模型服务之间搬运数据,还要自行处理任务拆分、并发控制、限流、重试和结果写回。与此同时,数据库已有的过滤、权限控制、资源管理和可观测能力,也很难覆盖这段独立的模型调用链路。
一个更自然的方向,是让模型能力直接进入 SQL,使其能够与过滤、Join、聚合和写表等操作组合使用。但对分析型数据库而言,“能够调用模型”只是第一步。真正需要解决的是:如何将高延迟、受配额约束的远程推理接入高吞吐的向量化执行链路,同时避免阻塞查询线程,并尽可能减少不必要的模型调用。
围绕这一问题,StarRocks 社区近期引入了 AI Function。用户可以直接在 SQL 中完成内容生成、分类、信息抽取和向量化等任务。更重要的是,模型调用也由此进入 StarRocks 的查询优化、Pipeline 执行和查询治理体系,与原有的数据处理能力协同执行。
从 SQL 表面看,AI Function 似乎只是增加了一类函数:
SELECT ticket_id,
       ai_complete(concat('概括这条工单:', content)) AS summary
FROM support_ticket
WHERE status = 'OPEN';
但对执行引擎而言,这并不是一次普通的字符串计算。每个非空输入都可能触发一次远程请求,其延迟同时受到网络和模型服务的影响;调用过程还可能遇到限流、重试或取消,并产生实际的 Token 消耗与费用。
如果将 HTTP 请求直接放入同步 UDF,Pipeline Driver 会在等待远程响应期间持续被占用;如果将推理完全移至数据库之外,StarRocks 又难以在调用模型前通过过滤、排序和 Limit 减少待处理的数据,也无法将查询取消、内存限制和运行指标等治理能力延伸至模型调用过程。
因此,StarRocks AI Function 的关键并不只是“让 SQL 能够调用模型 API”,而是将外部推理转化为数据库可以识别、调度和治理的工作单元。
一、函数是入口,AIProject 才是执行边界
AI Function 覆盖的不只是内容生成。分类、信息抽取、语义判断、向量化、多模态理解和多行归纳等任务,都可以通过相应函数进入 SQL。模型输出仍以数据列的形式存在,可以继续参与 Filter、Join、聚合或写表。其接口形态借鉴了 Snowflake Cortex AI Functions,但底层执行方式需要适配 StarRocks 的向量化 MPP 引擎。
从功能上看,这些函数可以分为四类:
-
ai_complete、ai_summarize、ai_translate等生成与内容转换函数; -
ai_filter、ai_classify、ai_extract、ai_similarity等判断与结构化处理函数; -
ai_embed、ai_embed_multimodal等向量化函数; -
ai_agg、ai_agg_summary等多行推理函数。
用户既可以使用系统默认模型,也可以显式配置 AI Model Resource。两种方式的区别在于模型配置的来源,不会改变下文介绍的整体执行框架。
普通标量函数通常具备两个特征:计算主要在本地完成;输入 Chunk 到达后,Driver 能够在一次相对短暂的调用中获得结果。远程模型调用同时打破了这两个前提。一个 Chunk 可能包含数千行,如果逐行同步等待响应,几乎无法获得可用的处理吞吐;如果在表达式内部一次性发起不受限制的并发,又可能使大量请求对象、响应数据和结果列同时堆积在内存中。
远程推理也改变了优化器需要面对的成本模型。普通谓词通常越早执行越好,但依赖 AI 结果的谓词只能在推理完成后执行;基于原始列排序的 TopN 可以提前裁剪数据,基于模型评分排序则无法提前完成;如果两处结构相同的 AI 表达式被分别执行,还会产生重复调用及额外费用。
因此,StarRocks 没有将 AI Function 作为普通表达式留在 Project 中。FE 会将模型调用抽取为独立的 AIProject ,BE 再将这一逻辑边界展开为专用 Pipeline。用户在 SQL 层仍然可以通过函数组合调用 AI 能力,远程推理则拥有独立的数据入口、并发窗口和生命周期。
二、FE:先确定调用语义,再减少模型输入
AI Function 进入 StarRocks FE 时,首先以普通函数调用的形式出现在表达式树中。完成函数重载解析后,函数对象会携带 AI 类型、模型来源、能力类型和参数模式等信息,供后续 Analyzer 和 Planner 处理调用语义。
模型名称、分类集合、返回格式和附加参数等控制项,会在这一阶段接受相应的类型检查与常量约束。使用 AI Model Resource 时,系统还会检查 Resource 是否存在、能力是否匹配,以及当前用户是否拥有 USAGE 权限。在物理计划序列化阶段,Planner 仅收集当前 AIProject 实际引用的模型配置,并通过节点中的配置映射将其下发至 BE。
随后,StarRocks 优化器会自底向上抽取表达式树中的 AI 调用,并使用新的 ColumnRef 表示调用结果。嵌套调用会被拆分为多层 LogicalAIProject :先计算并保存内层调用的结果,外层调用再读取对应列。
位于同一层且结构相同的 AI 调用会共享一个 ColumnRef,从而只触发一次模型求值。需要注意的是,这种复用仅适用于当前执行计划中的等价表达式,并不会自动识别不同数据行中的相同文本,更不会将其合并为一次模型请求。
AI 聚合函数采用了另一条执行路径。模型不会直接进入 Hash Aggregate 的状态机,而是先通过普通的 array_agg 收集组内数据,再将生成的数组交给内部 AI 标量函数处理。分组、Shuffle 和聚合仍由现有的分布式算子完成,模型调用仅发生在聚合结果行上。
当数组较小时,系统会将整组输入一次性放入模型上下文,即 Stuff 模式;当输入超过 Token 阈值时, AIArrayDispatcher 会根据预算进行切分,并执行 Map/Reduce 轮次。每一轮调用仍然复用统一的调度、限流和重试机制。
建立独立的 AIProject 后,优化器才能在不改变查询语义的前提下,调整其他算子与 AI 调用的执行顺序:
-
仅引用原始列的确定性谓词,可以下推至 AI 调用之前;依赖模型结果的谓词则保留在 AI 调用之后。
-
对于不包含 Offset,且排序列能够透传
AIProject的 TopN,优化器可以在 AI 调用前复制一层 TopN,提前裁剪候选数据;原有的最终 TopN 仍会保留,以确保查询结果不变。 -
普通 Limit 可以穿过不改变行数的 Project 向下传播,但不会越过需要依据 AI 结果进行判断的 Filter。
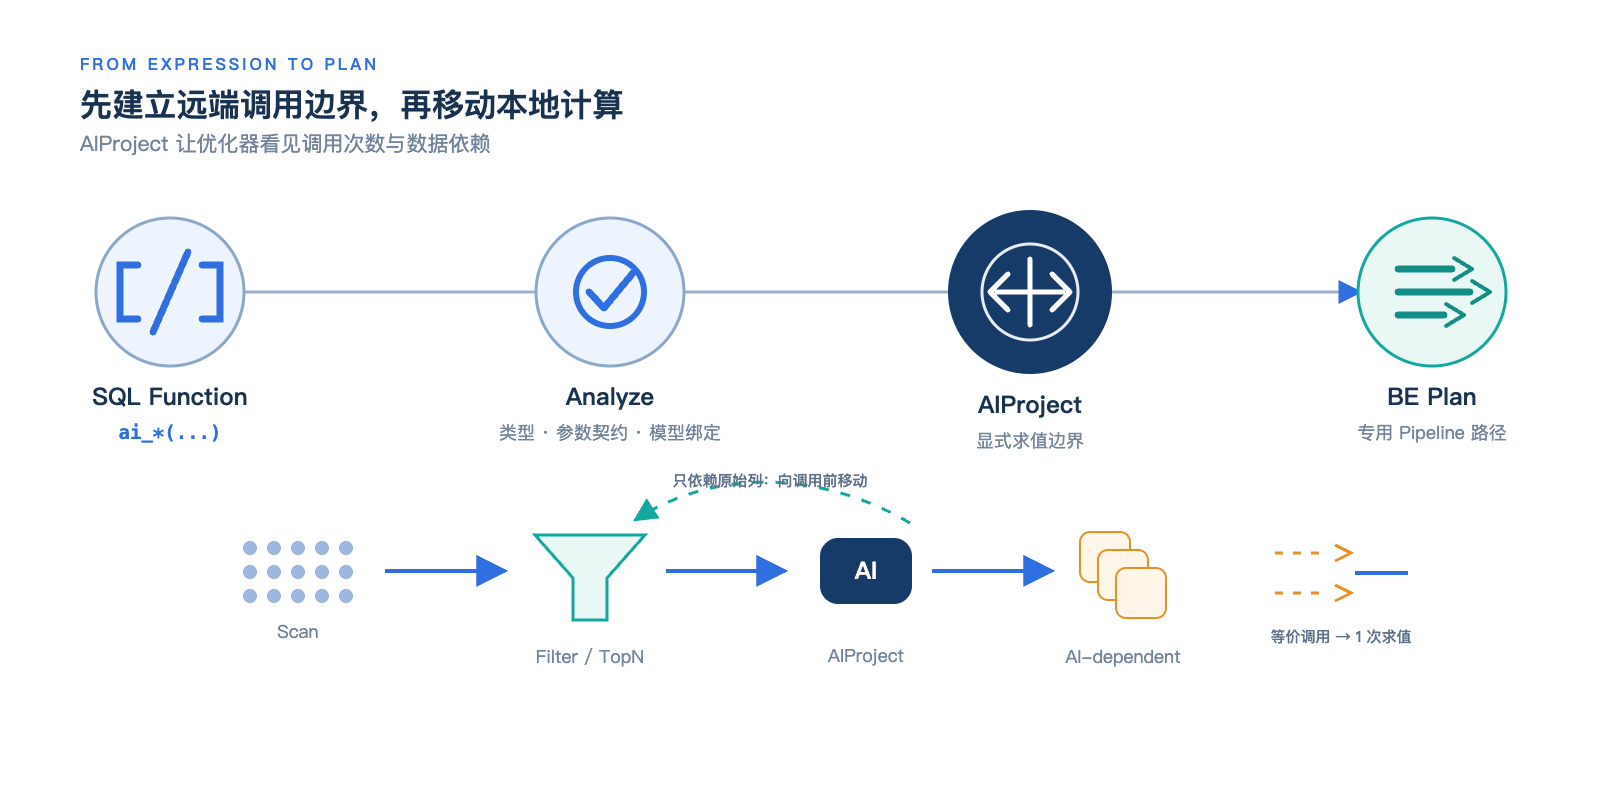
(图 1)
图 1 的重点并不在于增加了一个新的算子名称,而在于将“哪些数据行需要调用模型”转化为优化器可以处理的问题。Scan 和本地计算先缩小候选集, AIProject 仅处理真正需要推理的数据,后续算子再继续消费模型输出。对于模型推理这类高成本操作,减少一次不必要的调用,往往比优化普通函数的几条 CPU 指令更有价值。
进入物理规划阶段后, LogicalAIProject 会被转换为 PhysicalAIProject ,并最终生成 AIProjectNode 。该节点携带输出表达式、公共表达式,以及按照模型能力组织的配置信息。BE 解析相关表达式后,仅允许其通过 Pipeline 模式执行,避免 AI 调用意外回落至同步的 get_next() 路径。
三、BE:用双 Pipeline 隔开快数据与慢服务
在 StarRocks BE 中, AIProjectNode::decompose_to_pipeline() 会将一个逻辑节点拆分为上下游两条 Pipeline。上游仍由 Scan、Filter、Join 等本地算子组成,并在末端增加 AIBufferSinkOperator ;下游则从 AISourceOperator 开始。两条 Pipeline 通过 Fragment 内共享的 AIChunkBuffer 连接。
AIChunkBuffer 是一个支持多生产者、多消费者的共享 FIFO 队列,而不是按照 Driver 划分的独立通道。上游 Driver 将完整的 Chunk 写入队列,下游 Source 则竞争获取待处理的 Chunk。多个 Source 可以同时处理不同的 Chunk,从而提升远程推理的并发度,但执行框架不保证查询结果与全局输入顺序一致。如果 SQL 对结果顺序有明确要求,仍需显式使用 ORDER BY 。
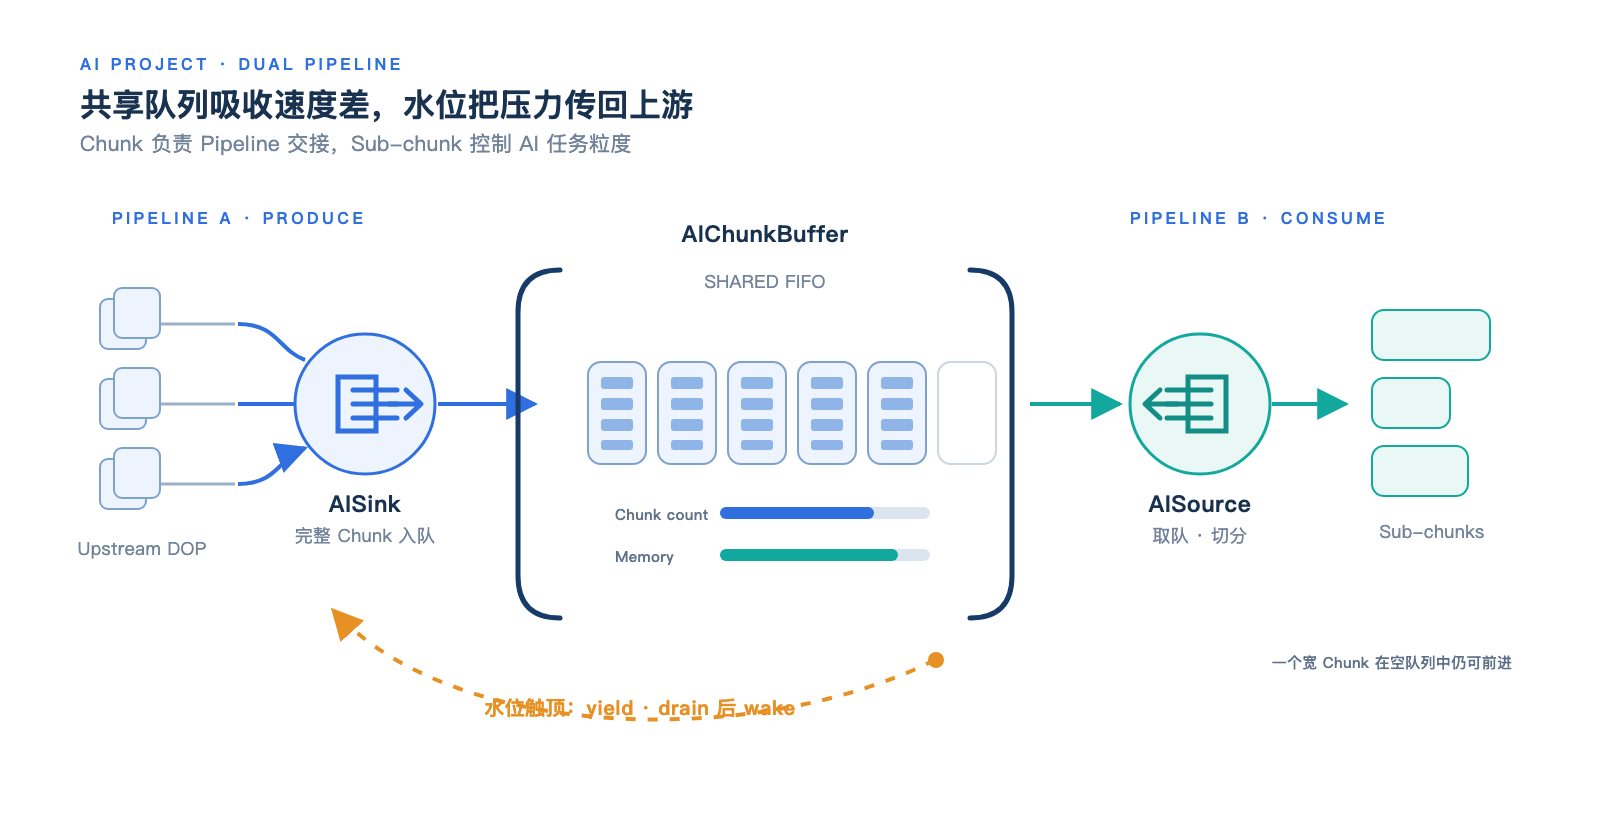
(图 2)
图 2 中,Buffer 只用于吸收本地数据生产与远程推理之间的短时速率差异,并同时监控队列中的 Chunk 数量和内存水位。当任一指标达到阈值后,Sink 的 need_input() 会返回 false ,Driver 随即进入 OUTPUT_FULL 状态并让出执行线程。Source 取走数据后,则通过 PipeObservable 唤醒上游继续写入。
如果单个输入 Chunk 本身就超过软内存水位,只要当前队列为空,Buffer 仍允许其进入,避免较宽的 Chunk 因始终无法满足水位要求而无法被接收。
每个 Sink 结束时都会递减生产者计数,只有全部 Sink 完成后,Buffer 才会进入 EOS 状态。反向来看,如果 Limit 已满足或查询提前终止,全部 Source 完成后会关闭 Buffer,丢弃尚未消费的 Chunk,并唤醒仍在等待的生产者。这套双向结束协议可以避免上下游 Pipeline 在正常结束、提前结束或查询取消时相互等待。
Source 从 Buffer 中取得完整 Chunk 后,会根据 ai_function_sub_chunk_size 将其切分为更小的 sub-chunk。切分发生在消费侧:Buffer 仍使用 StarRocks 原有的 Chunk 作为上下游交接单位,AI 执行侧则通过更小的任务控制单次驻留的数据量和并发粒度。
对于包含 Limit 的执行计划,各个 Source 还会共享一份原子行数预算。Source 在切分 sub-chunk 时预留对应的行数,避免多个并行实例同时处理数据而共同越过 Limit。
每个异步 sub-chunk 任务都会克隆一套独立的表达式上下文,并持有对 QueryContext 的生命周期引用。公共表达式和普通投影仍在查询的内存管理范围内执行,AI 表达式则只能通过 AISourceOperator 的专用入口求值。这样既可以避免多个并发任务共享可变的 FunctionContext,也能确保异步任务完成前,其依赖的 RuntimeState 不会被提前释放。
四、异步执行:Driver 不等网络,bthread 等完成事件
双 Pipeline 划定了本地执行与远程推理之间的数据流边界,而真正将远程等待移出 Pipeline Driver 的,是 AISourceOperator 之后的异步任务桥接机制。
AISourceOperator 为一个 sub-chunk 创建任务后,首先将 Setup Task 提交至当前 WorkGroup 对应的 ScanExecutor。Setup Task 启动 bthread 后便立即结束,使 ScanExecutor 的 pthread 能够继续处理其他任务。随后,AI 表达式在 bthread 中构造请求并调用 AITaskDispatcher 。当任务等待 HTTP 响应、QPS 令牌或重试时间窗时, bthread::ConditionVariable 会挂起当前 bthread 并让出底层 pthread,从而避免占用普通 Pipeline 执行线程。
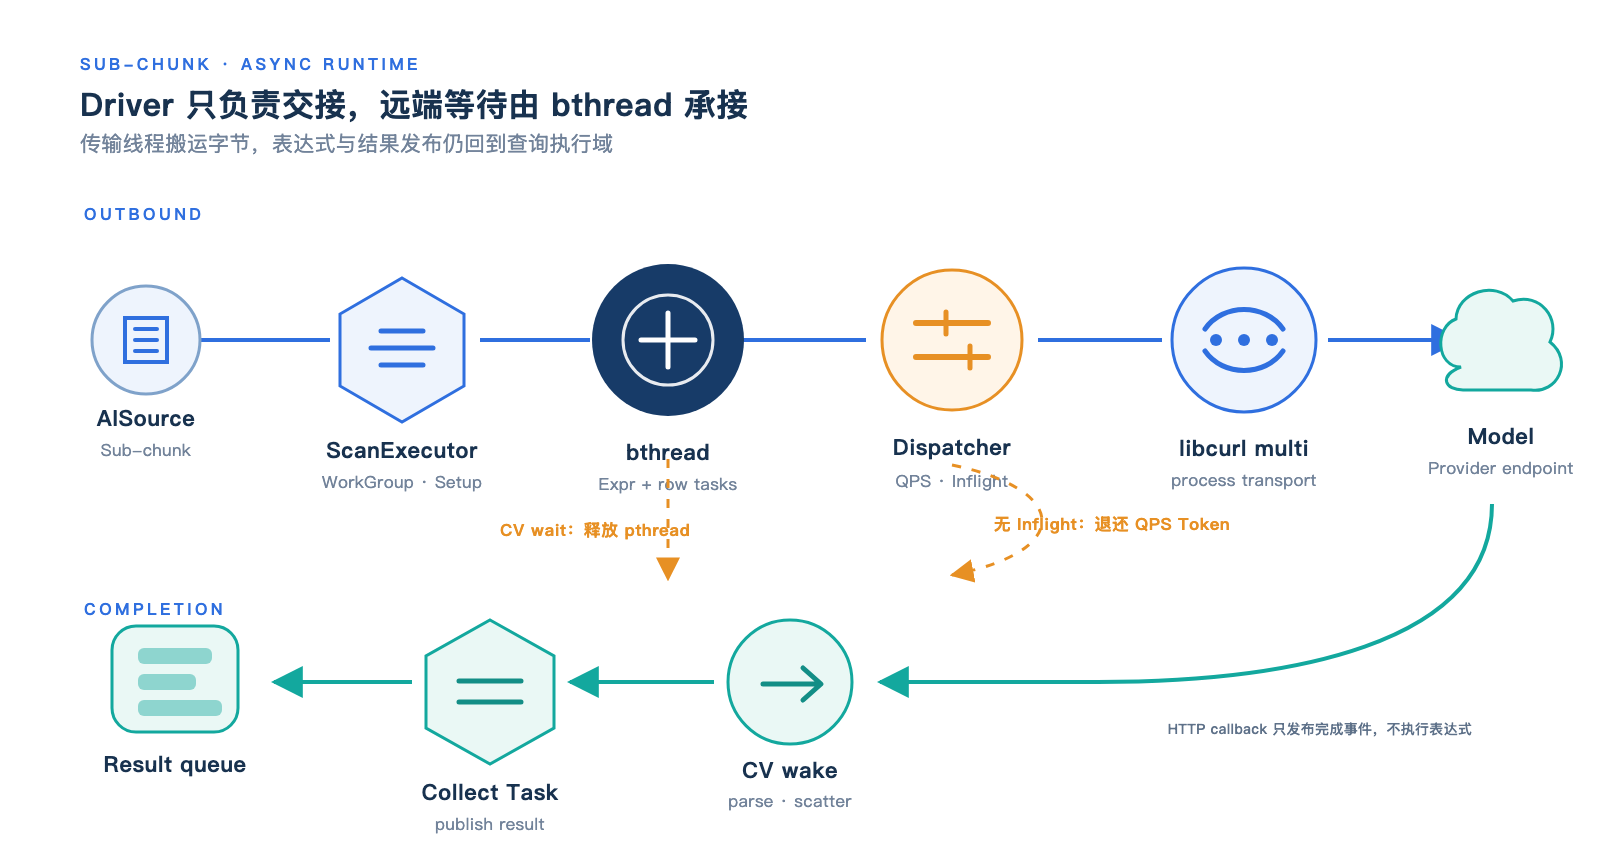
(图 3)
对于文本生成、分类和信息抽取等 Chat 类函数,sub-chunk 中的每个非空行通常会生成一个 AITask ,并携带原始 row index。即使结果以不同顺序返回,也会按照 row index 写回结果数组,最终生成与输入行一一对齐的结果列。
Embedding 函数还包含一层独立的 micro-batch 机制:多个非空文本会被合并到同一次向量请求中,返回的向量再根据原始位置写回对应行。sub-chunk 控制执行引擎侧的任务规模,micro-batch 控制向模型 Provider 发起请求的批次形态,两者解决的是不同层面的问题。
出站请求需要依次通过两层进程级准入控制。第一层是根据 endpoint、凭据身份和模型能力划分的 QPS Token Bucket;第二层是整个 StarRocks BE 共享的 Inflight 上限。如果请求已经取得 QPS Token,却暂时无法获得 Inflight 名额,Dispatcher 会退还 Token 并在稍后重新尝试,避免尚未实际发出的请求提前消耗速率预算。
通过准入控制后, AiHttpClient 会将不可变的请求对象交给进程级 libcurl multi transport。一个专用网络线程负责维护连接和数据传输,但不参与表达式计算。HTTP 完成后,回调只负责更新请求状态并唤醒相应的 bthread;随后由 Provider 适配层解析响应,提取 Token 用量和错误信息。
sub-chunk 处理完成后,bthread 会向 ScanExecutor 强制提交一个 Collect Task。该任务负责将结果 Chunk 写入 Source 的结果队列,并唤醒等待结果的 Driver。至此,一次异步推理重新接入 Pipeline 的数据流。
请求失败也通过同一条执行路径处理。传输错误、部分可重试的 HTTP 状态码和 429 响应,可以在设定的次数上限内重试;遇到 429 时,对应的限流桶还会进入指数退避。每次重试都需要重新通过 QPS 和 Inflight 准入控制。
请求超时时间会受到查询剩余执行时间的约束,取消信号则同时覆盖限流等待、网络传输和结果收集阶段。对于行级错误,系统可以根据会话策略终止整个查询,也可以将失败行的结果置为 NULL;查询取消或 deadline 到期则不会被降级为普通的行级错误。
不同模型之间的协议差异被限制在 Provider 层。执行计划负责告诉 BE 当前调用需要哪类模型能力,Provider 负责请求编码和响应解析,而任务调度、限流、内存管理和指标采集则由公共执行路径统一承担。因此,接入新的模型协议时,无须重新实现一套 Pipeline 执行机制。
五、背压不是一个开关,而是一条可观测的反馈链
AI 查询的压力可能来自三个方向:上游扫描速度过快、模型端点响应变慢,以及下游结果消费不及时。StarRocks 并非只依赖单一的并发参数,而是在数据流和请求链路上设置了多层连续边界。
Buffer 水位限制上游能够提前生产的数据量;Source 同时控制正在执行的 I/O 任务数量和结果队列规模;进程级 QPS 与 Inflight 限制则进一步约束实际离开 BE 的 HTTP 请求。
当模型响应变慢时,sub-chunk 的处理时间随之增加,Source 会逐步停止从 Buffer 获取新数据;Buffer 达到水位上限后,上游 Driver 也会减缓数据生产。下游消费受阻时,结果队列同样会将压力逐级向上传递,最终反馈至扫描端。
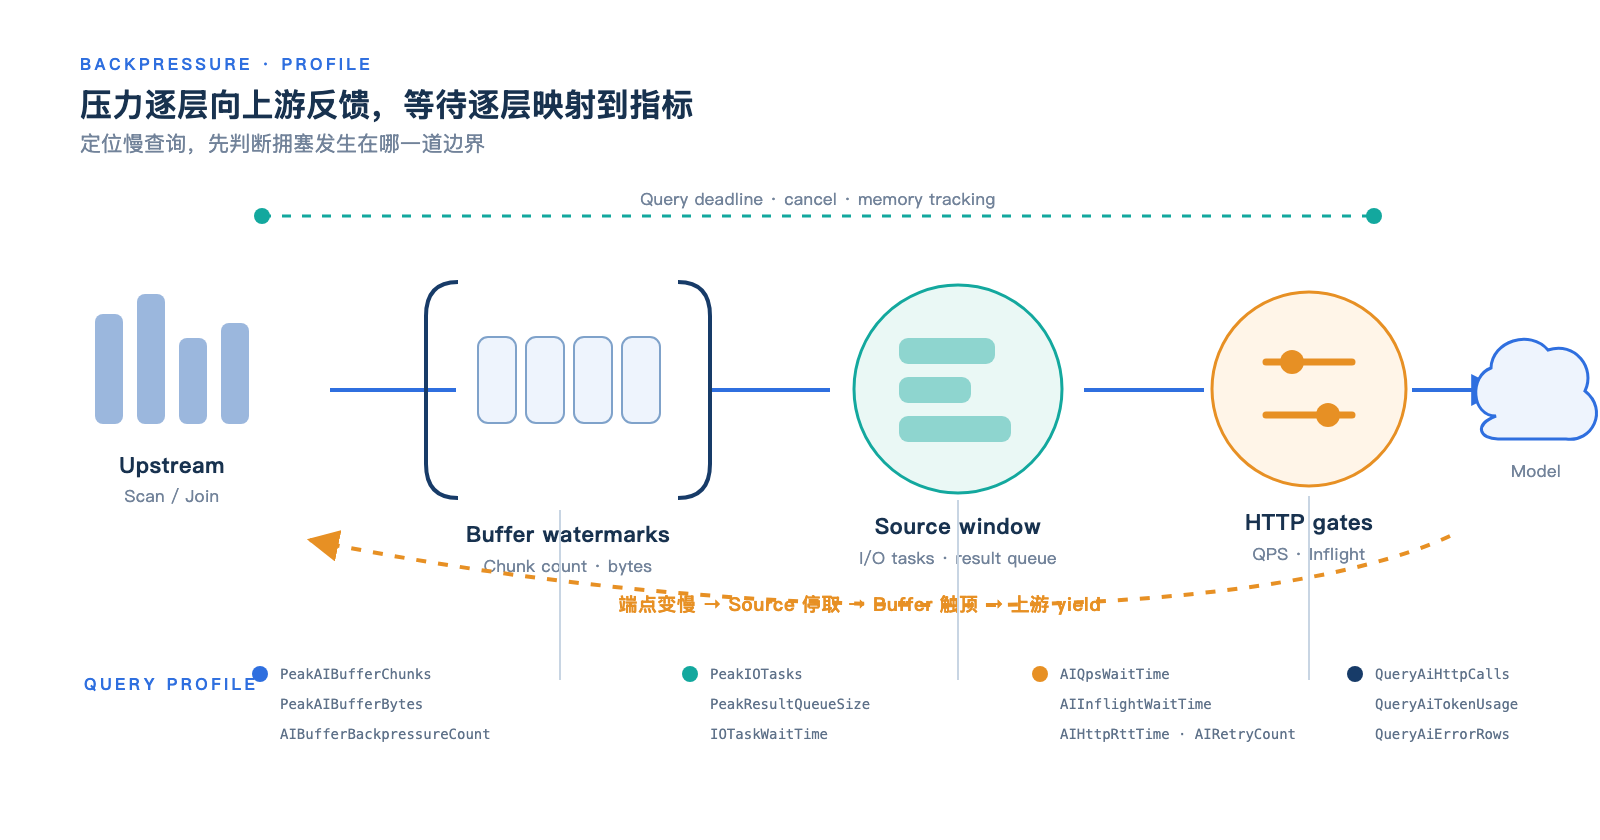
(图 4)
图 4 展示了上述压力反馈链在 StarRocks Query Profile 中的对应指标。 PeakAIBufferChunks 、 PeakAIBufferBytes 和 AIBufferBackpressureCount 用于描述两条 Pipeline 交界处的数据积压; PeakIOTasks 与 PeakResultQueueSize 反映 Source 侧正在执行的任务量和待消费的结果规模; AIQpsWaitTime 和 AIInflightWaitTime 则分别对应 QPS 配额等待与本地在途请求上限。 AIHttpRttTime 和 AIRetryCount 可以进一步反映模型端点及网络传输状态。
在查询层面,系统还会汇总 HTTP 调用次数、Token 用量和错误行数,使用户能够在同一份 Query Profile 中核对一次 SQL 的数据处理规模、模型调用量及相关成本。
需要注意的是,这些时间指标是多个并发任务的累计值,因此可能远大于查询的墙钟时间,不能将其直接相加并视为总耗时。排查慢查询时,更重要的是判断等待主要发生在哪一层:候选数据是否在模型调用前得到充分缩减,Buffer 是否持续触发背压,QPS 或 Inflight 是否成为主要瓶颈,还是模型 RTT 本身出现了长尾。
任务异步化也没有使相关内存脱离查询治理。Chunk 和表达式结果由实例级内存跟踪器管理,请求体及需要保留的响应体也会显式计入同一查询的生命周期,同时系统还会单独限制响应体大小。
每个 StarRocks BE 都独立维护 Token Bucket、Inflight 限制和 HTTP transport。如果一个查询分布在多个 BE 节点,而这些节点共享同一份模型服务配额,就需要根据所有节点可能产生的请求总量规划限流配置,或者由模型网关实施全局配额控制。
结语
StarRocks AI Function 连接了两类运行特征截然不同的系统:一端是高吞吐、向量化的数据执行引擎,另一端是高延迟、受配额约束的模型服务。
在 FE,StarRocks 通过 AIProject 明确模型调用的执行边界,并尽可能在调用前完成数据过滤和候选裁剪;在 BE,双 Pipeline 与有界 Buffer 将本地数据生产和远程推理解耦,再由 sub-chunk、ScanExecutor 和 bthread 承接异步任务。 AITaskDispatcher 、进程级限流器与 libcurl transport 共同管理出站请求,Query Profile 则将数据积压、等待时间、调用规模和 Token 成本重新关联到具体的 SQL 查询。
对用户而言,AI Function 仍是一组可以与 Join、聚合和写表组合使用的 SQL 函数;对执行引擎而言,模型调用已经成为一类边界明确、支持背压与取消、能够观测和计量的远程工作负载。这正是 StarRocks AI Function 与“在数据库函数中发起一次 HTTP 请求”的根本区别。
相关代码已合入 StarRocks Main 分支,将随下一版本正式发布。后续文章也将结合版本进展,进一步介绍不同能力的使用方式与适用场景。